Документы мы сгенерировали сами: 30 страниц с точно известным содержимым. Каждую сделали в двух вариантах — «чистом» и «скане»: серая бумага, поворот, размытие, шум, сильное сжатие JPEG. Почти как бумажка, которую сфотографировали на телефон в коридоре.
Посмотри, кто как читает
Квитанция ЖКХ — самое вредное, что у нас было: таблица из пяти столбцов с дробными числами. Нажми на картинку, чтобы увеличить, и переключай движки справа.
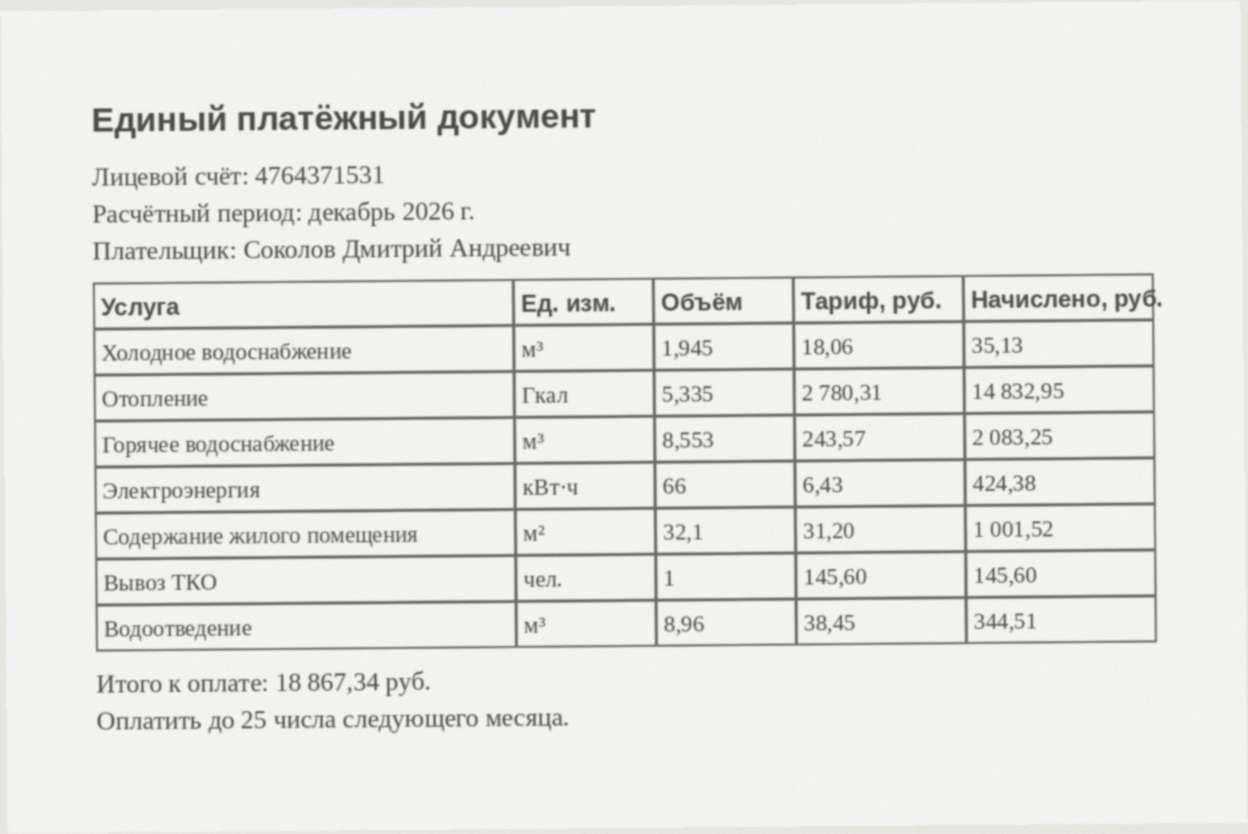
Единый платёжный документ
Лицевой счёт: 4764371531
Расчётный период: декабрь 2026 г.
Плательщик: Соколов Дмитрий Андреевич
| Услуга | Ед. изм. | Объём | Тариф, руб. | Начислено, руб. |
|---|---|---|---|---|
| Холодное водоснабжение | м³ | 1,945 | 18,06 | 35,13 |
| Отопление | Гкал | 5,335 | 2 780,31 | 14 832,95 |
| Горячее водоснабжение | м³ | 8,553 | 243,57 | 2 083,25 |
| Электроэнергия | кВт·ч | 66 | 6,43 | 424,38 |
| Содержание жилого помещения | м² | 32,1 | 31,20 | 1 001,52 |
| Вывоз ТКО | чел. | 1 | 145,60 | 145,60 |
| Водоотведение | м³ | 8,96 | 38,45 | 344,51 |
Итого к оплате: 18 867,34 руб.
Оплатить до 25 числа следующего месяца.
Единый платёжный документ
Лицевой счёт: 4764371531
Расчётный период: декабрь 2026 г.
Плательщик: Соколов Дмитрий Андреевич
Уcnyra Ед. изм. Объём Тариф, руб. Начислено,руб.
Холодное водоснабжение M3$ 1,945 18,06 35,13
Отопление Гкал 5,335 2780,31 14 832,95
Горячее водоснабжение m^{$ 8,553 243,57 2 083,25
Электроэнергия KBT·4 66 6,43 424,38
Содержание жилого помещения M^{$ 32,1 31,20 1001,52
ВыВОЗ TКО чел. 1 145,60 145,60
Водоотведение M3$ 8,96 38,45 344,51
Итого к оплате: 18 867,34 руб.
Оплатить до 25 числа следующего месяца.Единый платёжный документ Лицевой счёт: 4764371531 Расчётный период: декабрь 2026 г. Плательщик: Соколов Дмитрий Андреевич ели [м [ббым [Tapnd. py. [Heron nd опоре pe fis fase во | очен м а рой onus | | | | Содержание жилого помещения 1001,52 Bo TRO 15 | 43 Водоотведение Итого к оплате: 18 867,34 руб. Оплатить до 25 числа следующего месяца.
HunyuanOCR отдал таблицу целиком в Markdown, без единой ошибки. PP-OCRv5 прочитал все числа, но таблицу выдал просто строками, а «м³» превратил в «M3$». Tesseract, который стоит в Paperless-ngx и OCRmyPDF, таблицу не осилил вовсе: «ели [м [ббым [Tapnd. py.».
Точность против скорости
- HunyuanOCR — главное открытие фазы. Модель всего на 1 миллиард параметров читает так же точно, как универсальная Qwen3-VL-8B, но втрое быстрее и вдвое легче. И таблицы сохраняет.
- PP-OCRv5 ESLAV — тот же, что в Immich. На CPU, полсекунды на страницу, 1.5–2% ошибок. Отличный вариант для поиска по архиву, если таблицы не важны.
- Qwen3-VL и Qwen3.5-4B тоже читают почти идеально, но тратят 18–31 секунду на страницу.
- dots.ocr точный, но на этом iGPU у него ломается визуальная часть, и её приходится считать на CPU: 87 секунд на страницу.
- PaddleOCR-VL на целой странице зацикливается на пустых строках. Ему нужен свой конвейер с разметкой страницы, а у нас его нет.
Документ → JSON
Что нам на самом деле нужно от квитанции — не текст, а «лицевой счёт 4764371531, период декабрь 2026, к оплате 18 867,34». Проверили два пути:
- Одна модель смотрит на картинку и сразу выдаёт JSON.
- Сначала OCR, потом текст разбирает LLM (Qwen3.5-4B, лучший быстрый извлекатель из фазы про LLM).
Оба пути дают почти одно и то же. Qwen3.5-4B со зрением напрямую с картинки выдаёт 98.1% верных полей за 24 секунды. HunyuanOCR → Qwen3.5-4B — 98.5% за 27 секунд, и в придачу получаешь чистый текст страницы. Это почти потолок: на идеальном тексте без OCR тот же Qwen3.5-4B выдаёт 99%.
Качество OCR передаётся дальше один в один
Плохой OCR в начале — плохой JSON в конце. После PP-OCRv5 квитанции ЖКХ разбираются только на 83%: таблица без столбцов, и LLM путает, где тариф, а где объём. После Tesseract — на 16%.
Для Paperless-ngx
Штатный Tesseract плохо читает русские сканы с таблицами. Если хочется нормального поиска по документам, текст лучше получать HunyuanOCR или PP-OCRv5 и отдавать в Paperless через свой предобработчик или API.
Большие модели здесь не досчитали
Qwen3.6-35B и Gemma 4 26B с картинками на этой сборке llama.cpp капризничают: через несколько страниц начинают отвечать пустотой или мусором, а Gemma ещё и не влезает в память на большом контексте. Как это обойти, мы выяснили на вопросах по фото. Здесь повторять не стали: HunyuanOCR и Qwen3.5-4B и так почти у потолка, большая модель выводов не изменит.
Ограничения
- Документы синтетические: печатные шрифты, без рукописного текста, печатей и многоколоночной вёрстки.
- «Скан» — программная имитация. Настоящие фото под углом и с тенью от руки могут оказаться тяжелее.